Cara Kerja SEO: Crawling, Indexing, Retrieval, dan Ranking
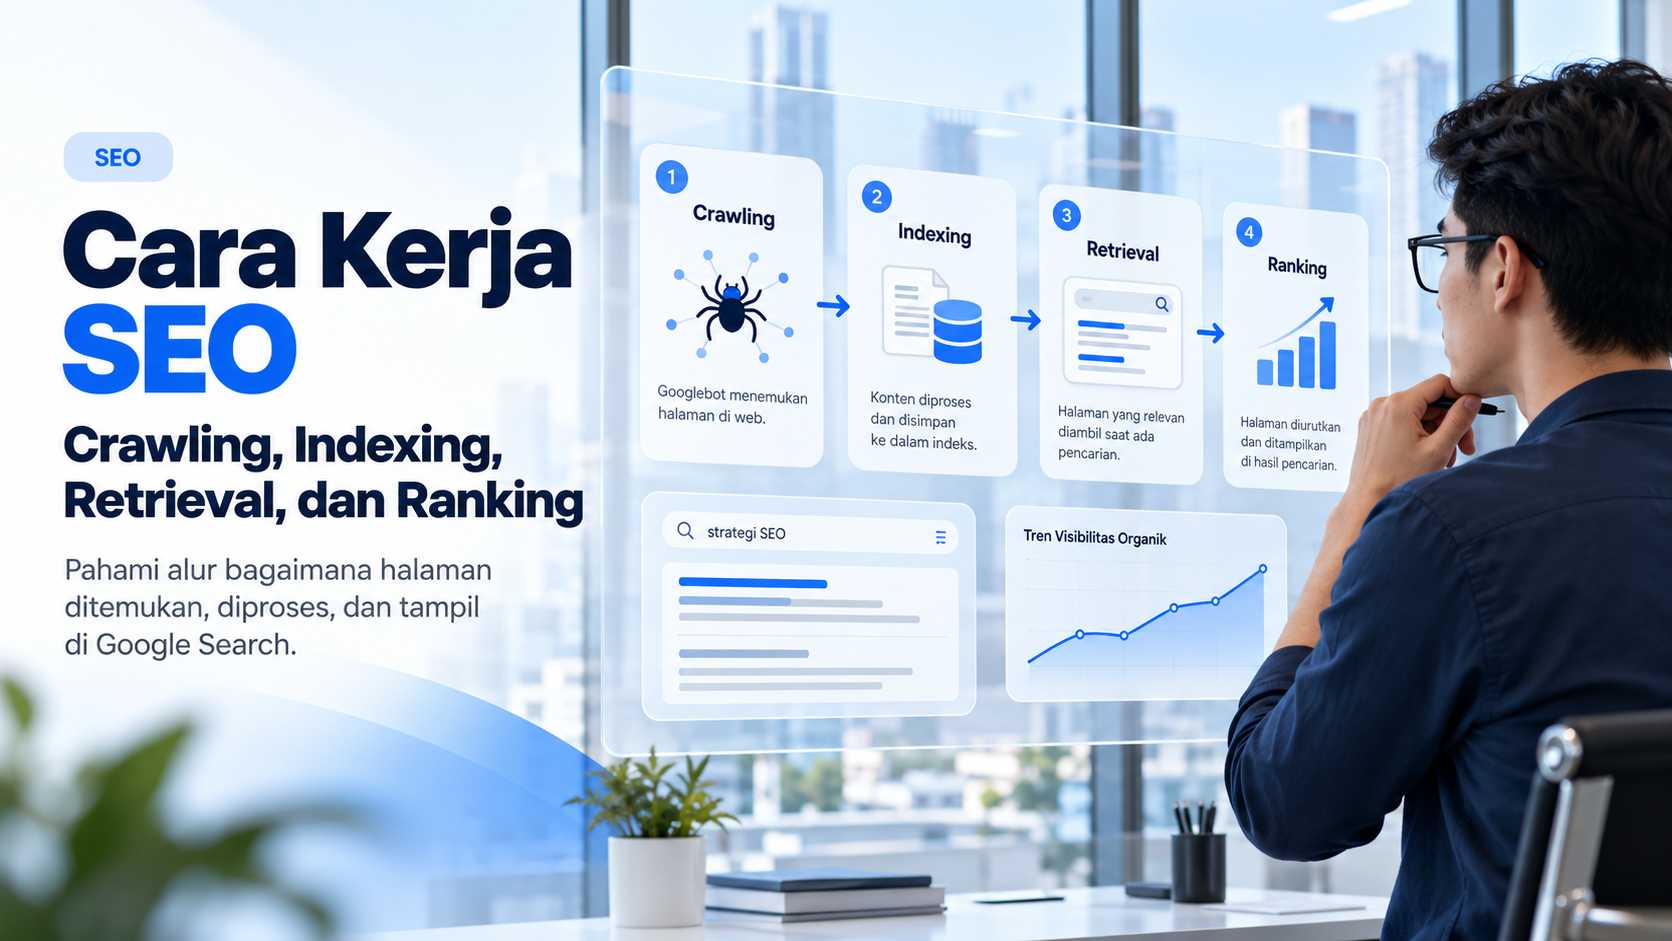
Cara kerja SEO mengikuti bagaimana mesin pencari menemukan, memahami, lalu memilih halaman yang akan ditampilkan ketika seseorang melakukan pencarian.
Sebelum sebuah halaman dapat memperoleh ranking, Google perlu menemukan URL melalui crawling, memproses dan memahami halaman melalui indexing, mencocokkannya dengan pencarian yang relevan, lalu menentukan posisi halaman di hasil pencarian.
Simak artikel ini sampai selesai untuk mempelajari cara kerja SEO dari crawling, indexing, retrieval, hingga ranking, serta cara mendiagnosis tahap yang menghambat visibility website Anda.
Bagaimana Cara Kerja SEO di Mesin Pencari?
SEO adalah serangkaian optimasi yang membantu mesin pencari menemukan dan memahami halaman, sekaligus membantu pengguna memperoleh informasi yang sesuai dengan apa yang mereka cari.
Google secara resmi menjelaskan bahwa Google Search bekerja melalui tiga tahap utama:
- Crawling, yaitu menemukan dan mengunduh halaman.
- Indexing, yaitu menganalisis halaman dan menyimpan informasi yang dipahami ke dalam Google Index.
- Serving search results, yaitu mencari informasi dari index dan menampilkan hasil yang dianggap relevan ketika pengguna melakukan pencarian.
Tidak semua halaman otomatis berhasil melewati setiap proses tersebut. Bahkan halaman yang mengikuti Google Search Essentials pun tidak dijamin selalu akan di-crawl, di-index, atau ditampilkan dalam hasil pencarian.
Agar mekanismenya lebih mudah dipahami dari sudut pandang SEO, dalam artikel ini tahap serving search results akan kita pecah secara konseptual menjadi dua proses:
Retrieval → Ranking
Retrieval di sini bukan “tahap resmi keempat Google”, tetapi cara untuk menjelaskan proses ketika sistem mencari kandidat yang relevan dari index sebelum menentukan hasil mana yang sebaiknya ditampilkan lebih tinggi.
| Tahap | Pertanyaan yang Dijawab Search Engine |
| Crawling | Apakah halaman ini dapat ditemukan dan diakses? |
| Indexing | Apa isi halaman ini dan apakah informasi tersebut dapat masuk ke index? |
| Retrieval | Apakah halaman ini relevan untuk pencarian yang sedang dilakukan? |
| Ranking | Dibanding kandidat lainnya, seberapa layak halaman ini ditampilkan lebih tinggi? |
Cara paling praktis untuk memahaminya adalah melihat SEO sebagai funnel of eligibility:
Crawlable → Indexable → Retrievable → Rankable → Visible
Sebuah halaman harus lolos dari tahap sebelumnya sebelum masalah pada tahap berikutnya menjadi relevan.
1. Crawling: Bagaimana Search Engine Menemukan Halaman Website?
Crawling adalah proses ketika mesin pencari menemukan dan mengakses URL menggunakan crawler seperti Googlebot.
Internet tidak memiliki satu daftar pusat yang berisi seluruh halaman website. Karena itu, Google terus mencari URL baru maupun URL lama yang mengalami perubahan. Google menyebut proses menemukan URL ini sebagai URL discovery.
Bagaimana Google Menemukan URL?
Beberapa jalur yang dapat membantu Google menemukan sebuah halaman antara lain:
- internal link dari halaman yang sudah diketahui Google;
- link dari website lain;
- XML sitemap;
- URL yang sebelumnya pernah dikunjungi;
- navigation, category page, atau hub page.
Bayangkan perusahaan baru saja membuat sebuah service page. Halaman tersebut sudah dapat dibuka apabila URL diketik langsung, tetapi tidak muncul di navigation, tidak mendapatkan internal link dari halaman lain, dan belum masuk XML sitemap.
Secara teknis halaman itu memang ada. Namun, Google mempunyai jalur discovery yang jauh lebih lemah dibanding halaman yang terhubung dengan struktur website. Inilah mengapa dalam audit SEO, jangan hanya melihat apakah URL “bisa dibuka”, tetapi juga bagaimana crawler dapat menemukan URL tersebut dari keseluruhan architecture website.
Apa yang Dapat Menghambat Crawling?
Beberapa masalah yang sering membuat proses crawling menjadi kurang optimal antara lain:
- directory penting terblokir melalui robots.txt;
- server error;
- broken internal link;
- JavaScript atau rendering bermasalah;
- orphan page;
- struktur website terlalu dalam;
- terlalu banyak duplicate atau parameter URL yang tidak diperlukan.
Pada website berskala besar, masalah seperti URL parameter dan faceted navigation juga dapat membuat crawler menghabiskan banyak resource pada URL yang sebenarnya tidak penting.
Namun, prinsip dasarnya adalah, jika crawler tidak dapat menemukan atau mengakses sebuah halaman, menambahkan keyword atau backlink pada halaman tersebut tidak menyelesaikan akar masalahnya. Karena itu, pemeriksaan Technical SEO menjadi salah satu fondasi pertama ketika visibilitas website bermasalah.
2. Indexing: Bagaimana Google Memahami dan Menyimpan Halaman?
Berhasil ditemukan belum berarti sebuah halaman otomatis masuk ke Google Index. Setelah crawling, Google mencoba memahami apa yang terdapat dalam halaman tersebut. Proses inilah yang disebut indexing.
Dalam proses indexing, Google dapat menganalisis berbagai informasi seperti:
- teks utama;
- title;
- heading;
- gambar;
- video;
- link;
- atribut tertentu pada halaman;
- serta hubungan halaman dengan URL lain yang memiliki konten serupa.
Google juga melakukan proses canonicalization. Jika ditemukan beberapa URL dengan konten yang sama atau sangat mirip, Google dapat mengelompokkannya dan memilih satu URL yang dianggap paling representatif sebagai canonical.
Search engine sedang mencoba menjawab beberapa pertanyaan:
- Halaman ini membahas apa?
- Informasi dan entitas apa yang ada di dalamnya?
- Apakah ada halaman lain yang isinya sangat mirip?
- URL mana yang sebaiknya menjadi representasi utama?
Crawled Tidak Selalu Berarti Indexed
Ini salah satu kesalahan yang cukup sering kami temukan ketika menganalisis website. Googlebot dapat berhasil mengakses URL, tetapi hal itu belum berarti URL tersebut pasti tersedia di index.
Beberapa penyebabnya antara lain:
- terdapat directive noindex;
- masalah duplicate dan canonicalization;
- halaman mempunyai sedikit unique value;
- soft 404;
- rendering bermasalah;
- atau halaman belum dipilih Google untuk indexing.
Contohnya, sebuah ecommerce mempunyai 10.000 product page. Googlebot berhasil mengakses sebagian besar URL tersebut. Namun, ribuan halaman hanya mempunyai nama produk berbeda sementara deskripsi, spesifikasi, dan kontennya hampir identik.
3. Retrieval: Bagaimana Search Engine Menemukan Kandidat yang Relevan?
Setelah sebuah halaman masuk index, untuk pencarian apa halaman tersebut relevan? Google menggunakan istilah resmi serving search results untuk proses setelah indexing. Dalam artikel ini, kami menggunakan istilah retrieval untuk menjelaskan secara konseptual proses ketika sistem mencari informasi atau halaman dalam indeks yang relevan dengan query pengguna.
Konsep ini membantu kita memahami bahwa indexed belum berarti sebuah halaman otomatis menjadi kandidat untuk setiap keyword yang terdapat di dalamnya. Search engine perlu memahami hubungan antara query dengan informasi yang tersedia.
Beberapa hal yang ikut membentuk kecocokan tersebut antara lain:
1. Query Meaning
Apa sebenarnya yang dimaksud pengguna? Pencarian sering kali tidak dapat dipahami hanya dari kata per kata. Mesin pencari perlu memahami hubungan antara istilah, konsep, dan konteks.
Google sendiri memiliki sistem seperti neural matching dan RankBrain yang membantu menghubungkan konsep dalam query dengan halaman, termasuk ketika kata yang digunakan tidak sama persis.
2. Search Intent
Apa yang ingin dilakukan pengguna setelah melakukan pencarian? Pengguna mungkin ingin:
- mendapatkan informasi;
- membandingkan beberapa pilihan;
- menemukan produk;
- mencari lokasi;
- atau menggunakan sebuah layanan.
Karena itu, memahami search intent menjadi penting agar halaman tidak hanya memasukkan keyword, tetapi benar-benar menjawab kebutuhan yang ada di balik keyword tersebut.
3. Content Relevance
Apakah informasi di halaman sesuai dengan kebutuhan tersebut? Misalnya, seseorang mencari: “software akuntansi untuk perusahaan”. Membuat halaman yang berulang kali menyebut frasa tersebut tidak otomatis membuat halaman menjadi relevan.
Pembahasannya kemungkinan juga perlu mempunyai hubungan yang jelas dengan konsep seperti:
- accounting;
- laporan keuangan;
- invoice;
- financial management;
- automation;
- integrasi sistem;
- hingga kebutuhan perusahaan.
Di sinilah pendekatan Semantic SEO menjadi relevan.
Search engine modern tidak hanya bergantung pada exact-match keyword. Sistem Google semakin mampu memahami hubungan antara kata dan konsep.
4. Context
Hasil yang relevan juga dapat dipengaruhi oleh konteks query, misalnya kebutuhan terhadap informasi terbaru, lokasi, bahasa, atau tipe hasil tertentu. Karena itu, SEO modern tidak hanya memastikan sebuah keyword terdapat di halaman.
Tujuannya adalah memastikan mesin pencari dapat memahami: kapan dan untuk kebutuhan pencarian apa halaman tersebut layak menjadi kandidat jawaban.
4. Ranking: Bagaimana Google Menentukan Urutan Hasil Pencarian?
Setelah menemukan sekumpulan kandidat yang relevan, search engine masih perlu menjawab pertanyaan berikutnya: Kandidat mana yang sebaiknya ditampilkan lebih tinggi?
Google menggunakan sistem ranking otomatis yang melihat banyak faktor dan sinyal dari ratusan miliar halaman serta informasi lain dalam search index untuk menyajikan hasil yang dianggap paling relevan dan berguna.
Daripada mencoba menghafal daftar “200 ranking factors”, lebih mudah memahami ranking melalui beberapa kelompok konsep.
1. Relevance
Seberapa dekat informasi pada halaman dengan kebutuhan di balik query? Halaman yang membicarakan topik yang sama belum tentu mempunyai intent yang sama. Misalnya: “jasa SEO” dan “apa itu SEO”, keduanya berhubungan dengan SEO, tetapi membutuhkan tipe halaman yang sangat berbeda.
2. Kualitas dan Keandalan Informasi
Sistem Google juga berusaha memunculkan informasi yang berguna dan dapat diandalkan. Karena itu, konten idealnya bukan hanya panjang, tetapi mempunyai alasan yang jelas untuk dipercaya, yaitu informasi akurat, pembahasan substantif, pengalaman nyata, sumber yang relevan, atau expertise yang sesuai dengan topik.
Kami lebih memilih memperbaiki kualitas jawaban dibanding sekadar menambahkan ratusan kata agar artikel terlihat “lebih lengkap”.
3. Link dan Referensi
Google masih menggunakan sistem analisis link, termasuk PageRank, sebagai bagian dari core ranking systems. Link dapat membantu Google memahami hubungan antarhalaman dan memperkirakan halaman mana yang berguna untuk menjawab suatu query.
Karena itu, strategi Off Page SEO tetap mempunyai peran, terutama ketika kompetisi terjadi antara beberapa halaman yang sama-sama relevan.
4. Usability dan Pengalaman Pengguna
Halaman juga perlu nyaman digunakan. Website yang sulit dibaca, bermasalah secara teknis, atau menyulitkan pengguna menemukan jawaban dapat menghambat performa secara keseluruhan. Namun, penting untuk tidak melihat satu metrik pengalaman pengguna sebagai “tombol ranking”. SEO bekerja dari kombinasi berbagai aspek, bukan satu skor tunggal.
5. Konteks Query
Hasil pencarian juga dapat berbeda tergantung kebutuhan query, misalnya:
- lokasi;
- bahasa;
- kebutuhan freshness;
- serta jenis informasi yang relevan.
Jadi, ranking bukan proses mencocokkan satu halaman dengan satu keyword.
Ranking adalah proses membandingkan banyak kandidat untuk menentukan hasil yang paling sesuai dalam konteks pencarian tertentu.

Crawling, Indexing, Retrieval, dan Ranking: Di Mana SEO Bekerja?
Sampai di sini kita dapat melihat mengapa diagnosis SEO sebaiknya dilakukan berdasarkan tahap.
| Tahap | Hambatan | Area SEO yang Berperan |
| Crawling | Halaman sulit ditemukan | Technical SEO, architecture, internal linking |
| Indexing | Halaman tidak dipahami atau tidak dipilih untuk index | Technical SEO, canonicalization, content quality |
| Retrieval | Halaman tidak dianggap relevan | Search intent, semantic content, topical coverage |
| Ranking | Relevan tetapi kalah dengan kandidat lain | Content quality, links, authority, usability |
| Visibility | Ranking ada tetapi exposure belum optimal | Query coverage, snippet dan SERP optimization |
Misalnya sebuah service page tidak mendapatkan impression sama sekali. Respons pertama seharusnya bukan: “Tambah backlink.”
Diagnosisnya sebaiknya berurutan:
Apakah URL sudah ditemukan Google?
↓
Apakah sudah di-index?
↓
Apakah Google menghubungkannya dengan query yang kita targetkan?
↓
Apakah halaman sudah memperoleh ranking tetapi posisinya masih rendah?
Tahap yang bermasalah menentukan tindakan yang harus dilakukan. Dalam website perusahaan dengan puluhan, ratusan, atau ribuan halaman, cara diagnosis seperti ini menjadi semakin penting.
Pada project SEO, pendekatan Doxadigital tidak hanya melihat ranking keyword secara terpisah. Kami menghubungkan technical accessibility, indexability, search intent, semantic relevance, internal architecture, content, dan off-page optimization untuk menemukan bottleneck yang paling memengaruhi organic visibility.
Pendekatan seperti ini juga menjadi bagian dari layanan SEO Agency Jakarta Doxadigital.
Contoh: Perjalanan Sebuah Service Page hingga Muncul di Google
Agar lebih mudah dibayangkan, anggap sebuah perusahaan software membuat halaman baru: /software-crm/enterprise/. Bagaimana halaman tersebut dapat muncul di Google?
1. Crawling
Tim website menghubungkan halaman baru dari service hub dan memasukkannya ke XML sitemap. Google kemudian menemukan URL tersebut dan dapat melakukan crawling.
URL Created → Discovered → Crawled
2. Indexing
Google memproses halaman. Dari title, heading, body content, link, dan informasi lainnya, sistem memahami bahwa halaman tersebut membahas software CRM untuk perusahaan enterprise. Jika tidak terdapat masalah indexability yang signifikan, URL dapat tersedia dalam Google Index.
Crawled → Indexed
3. Retrieval
Beberapa waktu kemudian seseorang mencari: “enterprise CRM software”. Sistem pencarian mencari informasi dalam index yang berkaitan dengan kebutuhan tersebut. Jika halaman tadi dianggap mempunyai hubungan yang kuat dengan query dan intent pengguna, URL tersebut dapat masuk ke kumpulan kandidat relevan.
Indexed → Retrieved
4. Ranking
Halaman kemudian dibandingkan dengan kandidat lainnya. Sistem Google mempertimbangkan berbagai sinyal dan sistem untuk menentukan halaman yang paling relevan serta berguna. Jika halaman cukup kompetitif, halaman dapat memperoleh posisi pada SERP.
Retrieved → Ranked
Perjalanan lengkapnya dapat dibayangkan sebagai:
URL Created → Discovered → Crawled → Indexed → Retrieved → Ranked → Clicked → Converted
Jadi, jika sebuah halaman berhenti pada salah satu tahap, pekerjaan SEO selanjutnya ikut berubah. Halaman yang belum di-index membutuhkan diagnosis yang berbeda dengan halaman yang sudah berada di posisi 15.
Baca Juga: Semantic SEO: Optimasi SEO untuk Semantic Search Engine
Cara Mendiagnosis Masalah SEO Berdasarkan Tahapnya
Framework ini juga dapat digunakan sebagai checklist awal saat organic visibility tidak berkembang.
Jika Halaman Tidak Ditemukan Google
Periksa:
- internal link;
- XML sitemap;
- robots.txt;
- HTTP response code;
- crawlability;
- struktur website.
Tujuan diagnosisnya adalah memastikan Google mempunyai jalur yang jelas menuju URL.
Jika Halaman Di-crawl tetapi Tidak Terindeks
Periksa:
- directive noindex;
- canonical;
- duplicate content;
- kualitas dan unique value halaman;
- rendering;
- status indexing di Google Search Console.
Jangan menganggap request indexing sebagai solusi untuk semua kasus. Jika akar persoalannya berada pada duplicate content atau kualitas halaman, meminta Google melakukan crawl ulang belum tentu menyelesaikannya.
Jika Sudah Terindeks tetapi Tidak Mendapat Impression
Evaluasi:
- apakah memang terdapat search demand;
- keyword dan query yang ditargetkan;
- search intent;
- relevansi halaman;
- entity dan topical coverage;
- hubungan halaman dengan bagian lain di website.
Pada tahap ini biasanya masalahnya sudah bergeser dari “bisakah Google menemukan halaman?” menjadi “untuk pencarian apa Google menganggap halaman ini relevan?”
Jika Impression Ada tetapi Ranking Rendah
Evaluasi:
- gap dengan kompetitor;
- kecocokan search intent;
- kedalaman informasi;
- internal link;
- backlink dan reference;
- kualitas halaman;
- usability dan page experience.
Perhatikan halaman yang saat ini sudah menang di SERP. Bukan untuk menyalinnya, tetapi untuk memahami standar informasi dan tipe jawaban yang ternyata dibutuhkan pengguna.
Jika Ranking Tinggi tetapi Click Rendah
Evaluasi:
- title;
- meta description;
- search snippet;
- SERP feature;
- kecocokan promise pada title dengan query pengguna.
Ranking tinggi tidak selalu berarti traffic akan otomatis tinggi. Apabila halaman berada di posisi yang baik tetapi pengguna tidak tertarik mengkliknya, masalah sudah berpindah dari ranking menuju SERP visibility dan CTR. SEO menjadi lebih efektif ketika tim mengetahui di tahap mana visibility terhambat sebelum menentukan tindakan optimasi.
Kesalahan Memahami Cara Kerja SEO
1. Menganggap Crawled Sama dengan Indexed
Crawler dapat berhasil mengakses sebuah URL, tetapi Google belum tentu memasukkan URL tersebut ke index. Crawling dan indexing adalah proses yang berbeda.
2. Menganggap Indexed Berarti Pasti Ranking
Indexed hanya berarti informasi halaman tersedia dalam search index dan berpotensi dipertimbangkan ketika relevan. Itu bukan jaminan halaman akan ranking untuk keyword tertentu.
3. Menganggap Ranking Ditentukan Hanya oleh Keyword
Keyword membantu mesin pencari dan pengguna memahami topik halaman, tetapi search engine juga perlu memahami konsep, intent, relevance, serta berbagai sinyal lainnya. Google bahkan dapat menampilkan halaman yang relevan ketika kata di halaman tidak sama persis dengan query pengguna.
4. Langsung Membangun Backlink ketika Traffic Turun
Backlink tidak selalu menjadi jawaban. Jika halaman ternyata memiliki noindex, salah canonical, kehilangan relevansi karena search intent berubah, atau bahkan tidak bisa di-crawl, menambahkan backlink tidak menyelesaikan root cause.
5. Menganggap Ranking Sebagai Tahap Akhir SEO
Ranking hanyalah salah satu tahap menuju hasil bisnis. Untuk perusahaan, funnel sebenarnya masih berlanjut:
Ranking → Visibility → Click → Qualified Traffic → Conversion → Leads/Revenue
Karena itu, keberhasilan SEO sebaiknya tidak berhenti pada laporan posisi keyword.
Baca Juga: Google Site Indexing: Seni dan Cara URL Terindeks di Google
Pahami Cara Kerja SEO untuk Menemukan Bottleneck yang Tepat
Cara kerja SEO tidak dimulai dari ranking. Sebelum sebuah halaman dapat menghasilkan organic visibility, halaman tersebut perlu melewati beberapa proses:
- Crawling menentukan apakah halaman dapat ditemukan dan diakses.
- Indexing menentukan bagaimana halaman dipahami dan tersedia di dalam index.
- Retrieval membantu menjelaskan apakah halaman relevan untuk dipertimbangkan sebagai kandidat pada suatu query.
- Ranking menentukan bagaimana kandidat tersebut dibandingkan dengan hasil lain.
Ketika alur ini dipahami, keputusan SEO menjadi lebih rasional. Tim tidak langsung menambahkan artikel karena traffic turun. Tidak langsung membangun backlink karena ranking stagnan. Dan tidak berulang kali meminta indexing ketika sebenarnya halaman mempunyai masalah canonicalization. Yang dicari terlebih dahulu adalah bottleneck-nya.
Jika website perusahaan Anda sudah memiliki banyak halaman tetapi organic visibility belum berkembang sesuai target, Doxadigital dapat membantu mengidentifikasi apakah hambatan berasal dari technical SEO, indexing, content relevance, architecture, atau authority, kemudian menyusun prioritas optimasi berdasarkan target bisnis sehingga strategi SEO bisa tepat sasaran dan hasilnya bisa optimal.
Kunjungi layanan SEO Agency Jakarta untuk mendiskusikan strategi SEO website Anda.

Artikel Terbaru


