Tips Crawl Budget SEO untuk Website Besar: Prioritaskan Halaman yang Penting untuk Bisnis
Website besar seperti e-commerce, marketplace, dan publisher dapat memiliki ribuan hingga jutaan URL. Jumlah ini bisa terus bertambah karena penambahan produk, kategori, konten, serta penggunaan filter dan pengurutan.
Semakin banyak URL, semakin penting untuk memastikan Googlebot memprioritaskan halaman yang bernilai bagi bisnis. Pengelolaan crawl budget membantu mengurangi crawling pada URL yang kurang penting agar halaman yang berpotensi mendatangkan trafik organik tetap mudah ditemukan dan dirayapi.
Karena itu, pengelolaan crawl budget SEO perlu berfokus pada efisiensi crawling dan prioritas halaman. Berikut beberapa tips untuk mengoptimalkan crawl budget pada website besar.
Apa Itu Crawl Budget dalam SEO?
Untuk memahami cara mengoptimalkan crawl budget SEO, Anda perlu mengenali dua faktor yang memengaruhi aktivitas crawling Google. Kedua faktor ini berkaitan dengan kemampuan server website dan kebutuhan Google untuk mengunjungi URL tertentu.
1. Crawl Capacity Limit
Crawl capacity limit berkaitan dengan kemampuan server untuk melayani permintaan Googlebot tanpa mengalami gangguan. Faktor seperti response time, ketersediaan server, error HTTP 5xx, dan HTTP 429 dapat memengaruhi kapasitas crawling website.
Server yang merespons dengan baik memungkinkan Google meningkatkan aktivitas crawling sesuai kebutuhan. Sebaliknya, server yang lambat atau sering mengalami error dapat membuat Google mengurangi permintaan crawling.
2. Crawl Demand
Crawl demand menunjukkan seberapa besar kebutuhan Google untuk mengunjungi URL yang sudah diketahui. Kebutuhan ini dipengaruhi oleh jumlah URL dalam inventaris Google, popularitas halaman, kesegaran konten, serta kualitas dan relevansinya.
Halaman populer atau konten yang sering diperbarui dapat mendorong Google untuk melakukan crawling kembali. Namun, tidak semua URL yang tersedia di website memiliki tingkat kebutuhan crawling yang sama.
Apakah Semua Website Perlu Mengoptimalkan Crawl Budget?
Tidak semua website perlu memberikan perhatian khusus pada crawl budget SEO. Website dengan kurang dari sekitar 1.000 halaman biasanya tidak perlu terlalu mengkhawatirkan crawl budget secara mendalam, sehingga masalah indexing sebaiknya diperiksa dari aspek kualitas konten, duplikasi, canonical, dan internal linking terlebih dahulu.
Kenapa Crawl Budget Menjadi Masalah pada Website Besar?
Masalah muncul ketika jumlah URL yang dapat di-crawl bertambah jauh lebih cepat daripada jumlah halaman yang benar-benar bernilai bagi pencarian organik. Kondisi ini sering terjadi pada website dengan sistem filter dan parameter URL yang menghasilkan banyak kombinasi halaman.
Google memperingatkan bahwa faceted navigation dapat menciptakan ruang URL yang sangat besar, bahkan hampir tidak terbatas. Akibatnya, Googlebot berpotensi menghabiskan resource untuk mengunjungi URL filter yang kurang penting dan membutuhkan waktu lebih lama untuk menemukan halaman yang lebih relevan.
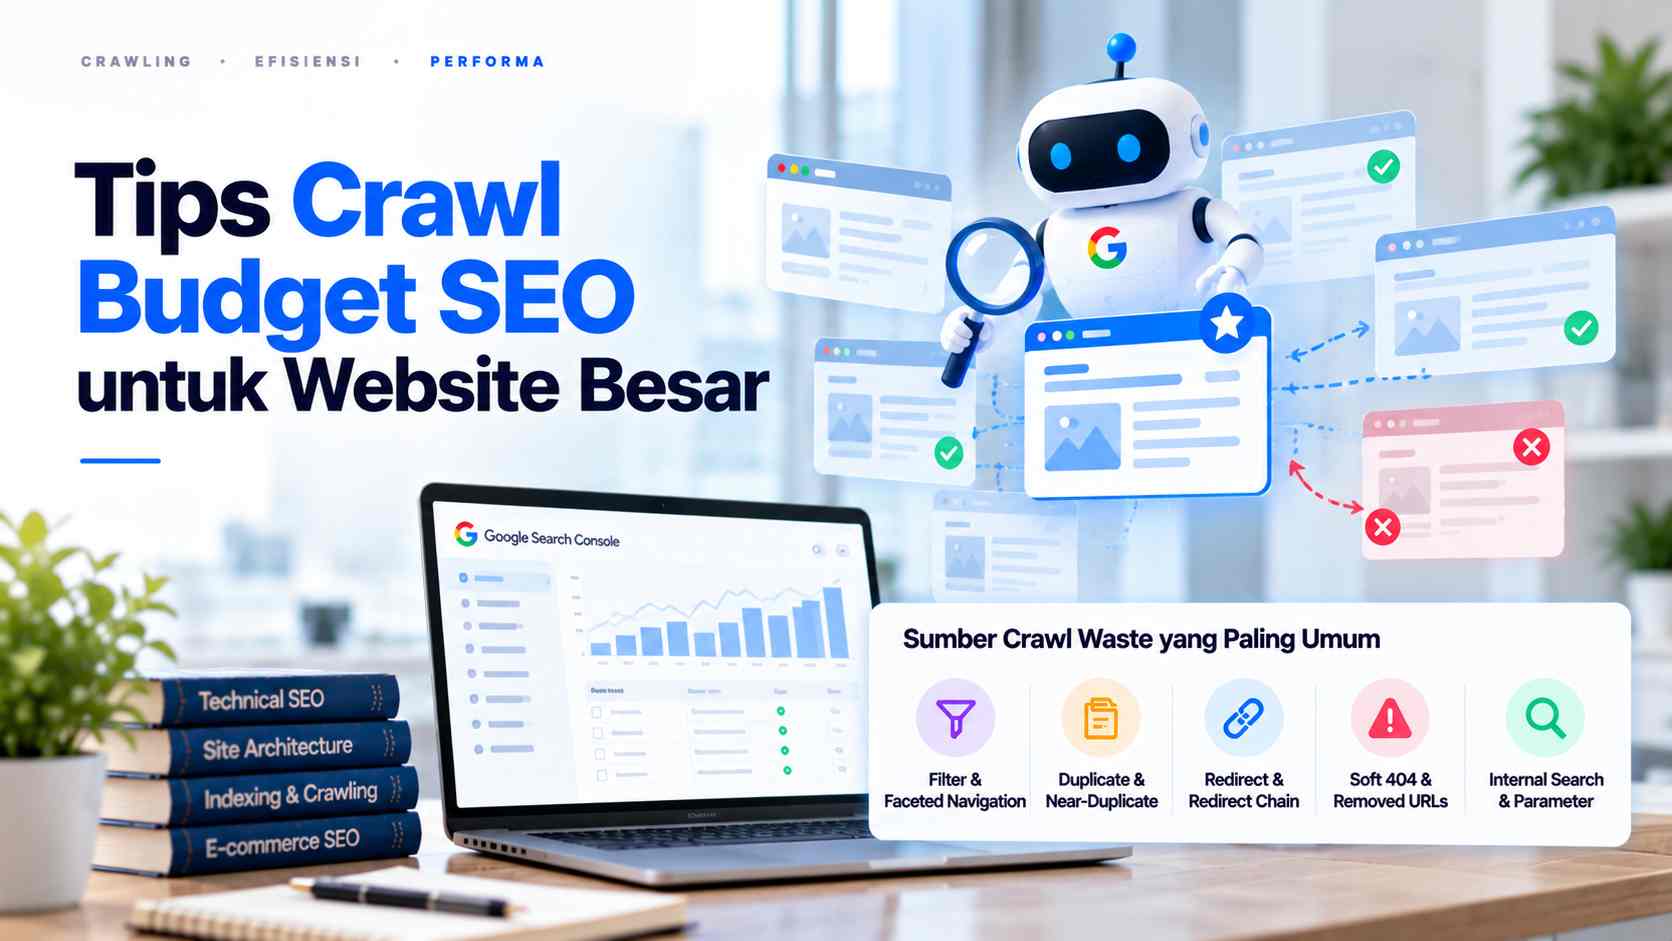
Sumber Crawl Waste yang Paling Umum pada Website Besar
Crawl waste terjadi ketika Googlebot menghabiskan aktivitas crawling pada URL yang tidak memberikan nilai berarti bagi pencarian organik. Berikut beberapa sumber yang perlu diperiksa untuk menjaga inventaris URL tetap terarah.
Filter berdasarkan harga, warna, ukuran, merek, atau atribut lain dapat menghasilkan banyak kombinasi URL. Tentukan filter yang memang dibutuhkan dalam Google Search, lalu batasi crawling pada kombinasi yang tidak memberikan nilai pencarian.
2. Duplicate dan Near-Duplicate URLs
URL berbeda dapat menampilkan konten yang sama atau hampir identik karena parameter, variasi navigasi, dan pengaturan website. Konsolidasikan halaman duplikat agar crawling lebih terfokus pada konten unik yang memiliki nilai bagi pengguna.
3. Redirect dan Redirect Chain
Redirect berantai membuat Googlebot melewati beberapa URL sebelum mencapai halaman tujuan. Perbarui tautan internal agar langsung mengarah ke URL akhir dan hindari rantai redirect yang panjang.
4. Soft 404 dan Removed URLs
Soft 404 terjadi ketika halaman terlihat seperti tidak tersedia, tetapi server tidak memberikan status HTTP yang sesuai. Untuk halaman yang benar-benar dihapus dan tidak memiliki pengganti, gunakan status 404 atau 410 agar Google memahami bahwa URL tersebut tidak lagi tersedia.
5. Internal Search dan URL Parameter
Fitur pencarian internal dapat menghasilkan URL baru dari setiap kata kunci atau kombinasi pencarian pengguna. Batasi crawling pada URL pencarian yang tidak memiliki nilai untuk Google Search agar jumlah URL tidak terus bertambah tanpa kebutuhan.
6. Low-Value URL Inventory
Halaman dengan konten tipis, variasi yang tidak relevan, atau informasi yang sudah tidak dibutuhkan dapat memperbesar inventaris URL. Evaluasi halaman tersebut berdasarkan manfaatnya bagi pengguna dan bisnis sebelum memutuskan untuk mempertahankan, menggabungkan, atau menghapusnya.
Baca Juga: Topical Authority: Definisi, Fungsi, Strategi Membangunnya
Prioritaskan URL Berdasarkan Search dan Business Value
Tidak semua halaman perlu mendapatkan prioritas yang sama dalam strategi crawl budget SEO. Kelompokkan URL berdasarkan kontribusinya terhadap visibilitas organik dan tujuan bisnis agar pengelolaan crawling lebih terarah.
Berikut ini adalah penjelasannya:
1. Tier 1 – Business Critical
Kelompok ini mencakup halaman yang berperan langsung dalam menghasilkan prospek, penjualan, atau konversi. Pastikan halaman berikut mudah ditemukan melalui struktur website dan memiliki internal link yang memadai.
- Halaman produk utama.
- Halaman kategori layanan atau produk.
- Halaman listing dengan permintaan pencarian tinggi.
2. Tier 2 – Search Supporting
Halaman pendukung membantu website menjangkau pencarian informasional dan memperkuat relevansi topik utama. Prioritaskan konten yang menjawab kebutuhan pengguna serta halaman filter tertentu yang memiliki permintaan pencarian nyata.
- Artikel pendukung.
- Kategori informasional.
- Halaman filter terpilih dengan search demand.
3. Tier 3 – Utility / Low Search Value
Halaman utilitas biasanya membantu pengguna menjalankan fungsi tertentu, tetapi tidak selalu perlu muncul di hasil pencarian. Evaluasi kebutuhan crawling dan indexing untuk halaman berikut sesuai fungsi serta karakteristik website.
- Halaman akun pengguna.
- Halaman pencarian internal.
- Variasi URL untuk pelacakan.

Cara Mengetahui Apakah Crawl Budget Benar-Benar Menjadi Masalah
Sebelum melakukan perubahan teknis, pastikan masalah crawling memang memengaruhi performa website. Anda dapat menggabungkan data Google Search Console, laporan indexing, server log, dan hasil audit SEO untuk menemukan sumber masalah.
Adapun cara mengetahui crawl budget menjadi masalah bisa cek beberapa hal di bawah ini:
1. Google Search Console – Crawl Stats
Laporan Crawl Stats di Google Search Console membantu Anda memahami aktivitas Googlebot pada website. Data yang tersedia mencakup jumlah permintaan crawling, ukuran unduhan, dan rata-rata waktu respons server.
Perhatikan apakah Googlebot terlalu sering mengakses URL yang tidak penting, terutama jika pola tersebut disertai peningkatan response time atau error HTTP 5xx. Perubahan jumlah crawling saja belum cukup untuk membuktikan adanya crawl budget problem, sehingga Anda perlu memeriksa pola dan dampaknya terhadap halaman penting.
2. Page Indexing Report
Page Indexing Report membantu Anda melihat status halaman yang ditemukan dan diproses Google. Perhatikan status Discovered – currently not indexed, Crawled – currently not indexed, serta soft 404 untuk menemukan pola yang perlu diperiksa lebih lanjut.
Status tersebut tidak selalu menunjukkan masalah crawl budget karena penyebabnya bisa berkaitan dengan kualitas konten atau proses indexing. Untuk memahami faktor yang memengaruhi Google indexing, periksa juga canonical, kualitas halaman, dan internal link yang menghubungkan halaman penting dengan bagian lain website.
3. Server Log Analysis
Analisis server log membantu Anda mengetahui permintaan Googlebot yang benar-benar terjadi di website. Data ini dapat menunjukkan direktori yang paling sering di-crawl, URL yang belum pernah diakses, serta status respons yang diterima crawler.
Bandingkan pola tersebut dengan prioritas bisnis untuk menemukan URL yang menyerap banyak permintaan tanpa memberikan manfaat berarti. Jika Googlebot terlalu sering mengakses halaman berulang atau tidak penting, evaluasi struktur URL dan aturan crawling yang digunakan.
4. SEO Crawler
SEO crawler membantu memetakan inventaris URL berdasarkan struktur website dan tautan internal. Gunakan hasil crawling untuk membandingkan jumlah URL yang tersedia dengan halaman yang benar-benar perlu ditemukan Google.
Pemeriksaan ini membantu Anda mengidentifikasi sumber URL berlebih dan memperbaiki struktur internal agar halaman prioritas lebih mudah dijangkau.
Baca Juga: Cara Kerja SEO: Crawling, Indexing, Retrieval, dan Ranking
Kesalahan Umum Saat Mengoptimalkan Crawl Budget
Optimasi crawl budget SEO perlu dilakukan berdasarkan data dan kebutuhan website, bukan sekadar mengurangi jumlah URL. Hindari beberapa kesalahan berikut agar perubahan teknis tidak justru menghambat crawling atau indexing halaman penting.
1. Menganggap Lebih Banyak Crawl Selalu Lebih Baik
Jumlah permintaan crawling yang tinggi tidak otomatis meningkatkan visibilitas organik website. Fokuskan optimasi pada akses Googlebot ke halaman yang penting, bukan sekadar meningkatkan jumlah permintaan.
2. Menggunakan Robots.txt Tanpa Memahami Indexing
Robots.txt digunakan untuk mengatur akses crawler terhadap URL, bukan sebagai alat universal untuk menghapus halaman dari indeks Google. URL yang diblokir masih berpotensi terindeks jika ditemukan melalui sumber lain, sehingga pengaturan ini perlu disesuaikan dengan tujuan website.
3. Menggunakan Canonical sebagai Pengganti Crawl Management
Canonical membantu Google menentukan URL utama di antara beberapa halaman yang serupa. Namun, jika filter URL tidak dibutuhkan dalam Google Search, mencegah crawling melalui pendekatan yang sesuai dapat lebih efektif dalam jangka panjang daripada hanya mengandalkan canonical.
4. Menambahkan Semua URL ke Sitemap
Sitemap sebaiknya berisi URL yang ingin Anda prioritaskan untuk ditemukan dan dipertimbangkan dalam indexing. Hindari memasukkan semua URL yang dihasilkan CMS, terutama halaman duplikat, URL parameter, atau halaman yang sudah tidak relevan.
5. Mengejar Crawl Budget Sebelum Menyelesaikan Indexation Quality
Penambahan aktivitas crawling belum tentu membuat halaman masuk ke indeks Google. Jika Google sudah mengunjungi halaman tetapi tidak mengindeksnya, periksa kualitas konten, duplikasi, canonical, dan relevansi halaman terlebih dahulu.
6. Mengoptimalkan Website Kecil Seolah Enterprise Website
Website kecil umumnya tidak membutuhkan analisis crawl budget yang terlalu kompleks. Fokuskan sumber daya pada kualitas konten, kesesuaian search intent, internal linking, indexability, dan authority agar upaya SEO memberikan hasil yang lebih relevan.
Optimalkan Crawl Budget SEO untuk Meningkatkan Organic Visibility
Semakin besar sebuah website, semakin penting memastikan Googlebot tidak menghabiskan resource pada URL yang tidak memberikan nilai bagi organic search. Pengelolaan crawl budget membantu Googlebot merayapi halaman website secara lebih efisien, terutama pada website besar dengan ribuan URL.
Dengan memprioritaskan halaman yang penting, bisnis dapat mendukung proses crawling dan indexing agar halaman yang relevan memiliki peluang lebih baik untuk muncul di hasil pencarian.
Jika perusahaan Anda mengelola website berskala besar, saatnya melakukan audit untuk menemukan sumber crawl waste dan menentukan prioritas optimasi yang tepat.
Konsultasikan kebutuhan Technical SEO website Anda dengan layanan SEO Agency Jakarta dari Doxadigital untuk membantu meningkatkan efisiensi crawling dan mendukung visibilitas organik bisnis Anda.

I’m an SEO Specialist and Creative Storyteller who bridges data, creativity, and search behavior to drive organic growth. Passionate about SEO, AI-driven discovery, and content strategy, I turn search insights into meaningful audience connections and measurable business impact.
Artikel Terbaru


